Inferenz aus einem Netz unabhängiger GPUs

Eine OpenAI-kompatible API für Chat, Code, Embeddings, Bilder und Video. Ungenutzte GPUs überall können beitreten und Credits verdienen.

curl
curl https://babelmesh.ai/v1/chat/completions \
  -H "Authorization: Bearer $BABEL_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "messages": [{"role": "user",
                  "content": "Explain a hash ring"}]
  }'
Das Gateway wählt das Modell und einen passenden Knoten.
0
verfügbare Modelle
none yet
was es jetzt kann

Vier Arten von Arbeit, ein Schlüssel

Das Bild und der Clip unten wurden im Netzwerk selbst erzeugt.

Chat und Code

Wählen Sie auto, und die Anfrage wird gelesen, nicht gespeichert: Kurze Fragen gehen an ein schnelles Modell, Code an ein Code-Modell, schwierige Probleme an das stärkste.

python
client = OpenAI(base_url="https://babelmesh.ai/v1",
                api_key="sk-fab-...")
client.chat.completions.create(
    model="auto", stream=True,
    messages=[{"role": "user", "content": "..."}])
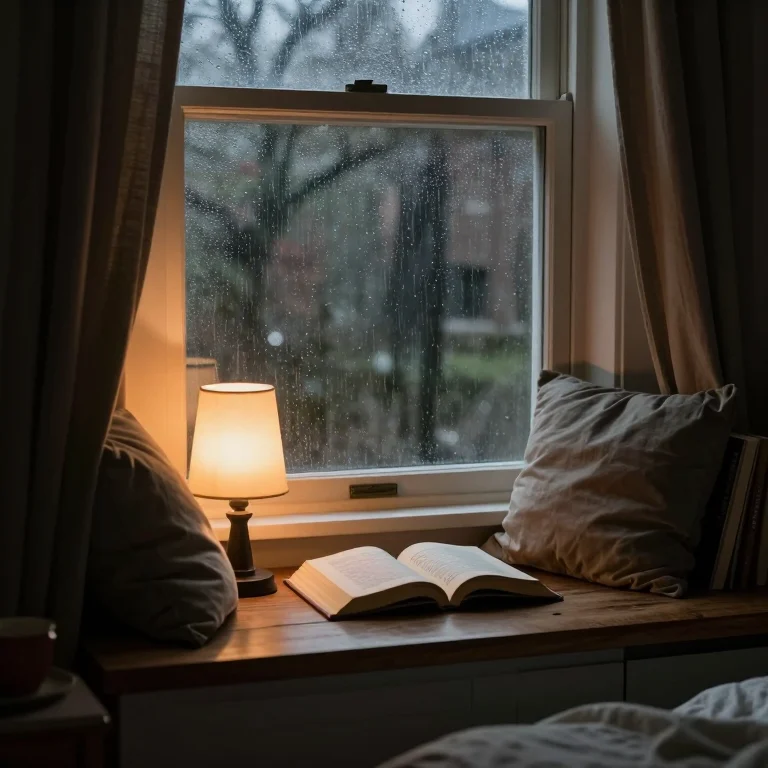
Bilder

Ein Satz, ein Bild.

Ein im Netzwerk erzeugtes Bild: eine Schreibtischlampe und ein aufgeschlagenes Buch an einem Fenster in einer regnerischen Nacht

Embeddings

Text zu Vektoren für Suche und Retrieval, mit einem kleinen Modell, das auf gewöhnlichen CPUs läuft.

curl
curl https://babelmesh.ai/v1/embeddings \
  -H "Authorization: Bearer $BABEL_KEY" \
  -d '{"model": "embedding-default",
       "input": ["a lighthouse at dawn"]}'

Video

Kurze Clips, im Hintergrund erzeugt. Es dauert einige Minuten, und die Datei ist nach Fertigstellung zum Speichern bereit.

Was mit einer Anfrage geschieht

  1. Senden

    Ihre App ruft die API mit einem Schlüssel auf, wie bei jedem OpenAI-kompatiblen Dienst.

  2. Verteilen

    Das Gateway wählt einen passenden Knoten: nach Modell, Prompt-Länge und aktueller Last.

  3. Berechnung

    Der Knoten führt das Modell aus und streamt die Antwort über das Gateway zurück.

  4. Prüfen

    Beide Seiten signieren einen Beleg, und ein Teil der Ergebnisse wird zur Kontrolle noch einmal berechnet.

Leihen Sie, was Sie haben

Verdienen Sie Credits, während Ihr Computer im Leerlauf ist. Es beginnt erst nach Ihrer Zustimmung, und Sie können jederzeit aufhören.

  • Eine Grafikkarte

    NVIDIA, AMD, Intel oder Apple Silicon. Sie bedient Chat, Code, Bilder und Video, während Sie weg sind.

  • Nur ein Prozessor

    Keine nutzbare GPU? Leihen Sie die CPU für kleine Modelle und Embeddings. Es wird nur etwa die Hälfte der Threads genutzt.

Heute und als Nächstes

Jetzt verfügbar

  • Chat, Code, Embeddings, Bilder und Video
  • Eine OpenAI-kompatible API, sodass vorhandene Tools einfach funktionieren
  • Eine Statusseite mit Live-Verfügbarkeit und -Geschwindigkeit

In Arbeit, ohne Termine

  • Der Babel-Mesh-Desktop-Client mit GPU- und CPU-Freigabe
  • Auszahlung verdienter Credits in bar, mit Identitätsprüfung und Kontrolle
  • Mehr und größere Modelle

Fragen

Wie wird es bezahlt?

Die Nutzung wird in Credits abgerechnet: nach Tokens bei Text und Embeddings, pro Bild und pro Videosekunde. Credits lassen sich auch durch das Teilen von Rechenleistung verdienen.

Können andere sehen, was ich sende?

Der Knoten, der Ihre Anfrage bearbeitet, kann sie lesen, sieht aber nicht, wer Sie sind. Babel Mesh speichert keine Unterhaltungen, und die Abrechnungsbelege enthalten nur Hashes und Nutzung. Nur eine Anfrage, die eine Inhaltsregel auslöst, hinterlässt einen kurzen Auszug um die Fundstelle. Senden Sie keine Passwörter, Ausweisnummern oder anderes sensibles Material. Mehr auf der Sicherheitsseite.

Wie unterscheidet sich das vom Mieten einer Cloud-GPU?

Anfragen werden auf viele unabhängige Maschinen verteilt. Sie mieten keine ganze Maschine und richten keine Umgebung ein, und Sie zahlen nach Nutzung. Angeboten wird Modell-Inferenz, keine reine GPU-Vermietung.

Welche Systeme und Karten können Rechenleistung teilen?

Windows und Linux (x86-64) mit NVIDIA-Karten (CUDA) oder AMD und Intel (Vulkan) sowie Macs mit Apple Silicon (Metal). Ein Computer ohne nutzbare Grafikkarte kann seinen Prozessor teilen. Der Client ist in Vorbereitung.