स्वतंत्र GPU के जाल से इन्फ़रेंस

चैट, कोड, एम्बेडिंग, चित्र और वीडियो के लिए एक OpenAI-संगत API। कहीं के भी निष्क्रिय GPU जुड़कर क्रेडिट कमा सकते हैं।

curl
curl https://babelmesh.ai/v1/chat/completions \
  -H "Authorization: Bearer $BABEL_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "messages": [{"role": "user",
                  "content": "Explain a hash ring"}]
  }'
गेटवे मॉडल और उसके लिए उपयुक्त नोड चुनता है।
0
उपलब्ध मॉडल
none yet
अभी यह क्या कर सकता है

चार तरह के काम, एक कुंजी

नीचे का चित्र और क्लिप नेटवर्क पर ही बनाए गए थे।

चैट और कोड

auto माँगें, तो अनुरोध पढ़ा जाता है, सहेजा नहीं जाता: छोटे सवाल तेज़ मॉडल के पास, कोड कोड मॉडल के पास, कठिन समस्याएँ सबसे सक्षम के पास जाती हैं।

python
client = OpenAI(base_url="https://babelmesh.ai/v1",
                api_key="sk-fab-...")
client.chat.completions.create(
    model="auto", stream=True,
    messages=[{"role": "user", "content": "..."}])
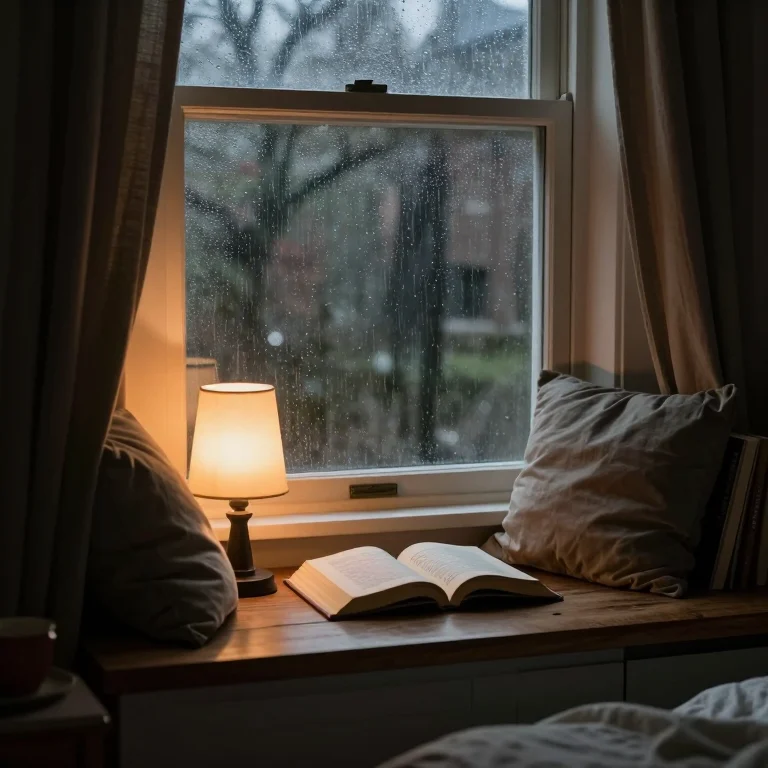
चित्र

एक वाक्य, एक चित्र।

नेटवर्क पर बनाया गया एक चित्र: बरसात की रात में खिड़की के पास एक डेस्क लैंप और एक खुली किताब

एम्बेडिंग

खोज और पुनर्प्राप्ति के लिए पाठ से वेक्टर, एक छोटे मॉडल पर जो साधारण CPU पर चलता है।

curl
curl https://babelmesh.ai/v1/embeddings \
  -H "Authorization: Bearer $BABEL_KEY" \
  -d '{"model": "embedding-default",
       "input": ["a lighthouse at dawn"]}'

वीडियो

छोटे क्लिप, पृष्ठभूमि में बनाए जाते हैं। इसमें कुछ मिनट लगते हैं, और पूरा होने पर फ़ाइल सहेजने के लिए तैयार होती है।

एक अनुरोध के साथ क्या होता है

  1. भेजें

    आपका ऐप API को एक कुंजी के साथ कॉल करता है, किसी भी OpenAI-संगत सेवा की तरह।

  2. भेजना

    गेटवे एक उपयुक्त नोड चुनता है: मॉडल, प्रॉम्प्ट की लंबाई और मौजूदा भार के आधार पर।

  3. गणना

    नोड मॉडल चलाता है और जवाब गेटवे के ज़रिए स्ट्रीम करके लौटाता है।

  4. सत्यापन

    दोनों पक्ष एक रसीद पर हस्ताक्षर करते हैं, और जाँच के लिए कुछ नतीजों की दोबारा गणना होती है।

जो आपके पास है, उसे उधार दें

अपना कंप्यूटर निष्क्रिय रहने पर क्रेडिट कमाएँ। यह आपकी सहमति के बाद ही शुरू होता है, और आप कभी भी रोक सकते हैं।

  • एक ग्राफ़िक्स कार्ड

    NVIDIA, AMD, Intel या Apple सिलिकॉन। आपके दूर रहने पर यह चैट, कोड, चित्र और वीडियो परोसता है।

  • सिर्फ़ एक प्रोसेसर

    उपयोग लायक GPU नहीं है? छोटे मॉडल और एम्बेडिंग के लिए CPU उधार दें। केवल लगभग आधे थ्रेड इस्तेमाल होते हैं।

आज और आगे

अभी उपलब्ध

  • चैट, कोड, एम्बेडिंग, चित्र और वीडियो
  • OpenAI-संगत API, इसलिए आपके मौजूदा टूल सीधे चलते हैं
  • उपलब्धता और गति को लाइव दिखाने वाला स्थिति पेज

प्रगति पर, कोई तारीख़ नहीं

  • GPU और CPU साझा करने की सुविधा वाला Babel Mesh डेस्कटॉप क्लाइंट
  • कमाए गए क्रेडिट का नकद भुगतान, जिसके लिए पहचान सत्यापन और समीक्षा चाहिए
  • और अधिक तथा और बड़े मॉडल

सवाल

भुगतान कैसे होता है?

उपयोग का शुल्क क्रेडिट में लगता है: पाठ और एम्बेडिंग के लिए टोकन के हिसाब से, चित्र के हिसाब से, और वीडियो के प्रति सेकंड के हिसाब से। गणना साझा करके भी क्रेडिट कमाए जा सकते हैं।

क्या दूसरे लोग देख सकते हैं कि मैं क्या भेजता हूँ?

आपका अनुरोध संभालने वाला नोड उसे पढ़ सकता है, पर यह नहीं देख सकता कि आप कौन हैं। Babel Mesh बातचीत सहेजता नहीं, और लेखा रसीदों में केवल हैश और उपयोग होता है। केवल वही अनुरोध जो सामग्री के नियम को ट्रिगर करता है, मिलान के आसपास का एक छोटा अंश छोड़ता है। पासवर्ड, पहचान संख्या या अन्य संवेदनशील सामग्री न भेजें। और जानकारी सुरक्षा पेज पर।

यह क्लाउड GPU किराये पर लेने से कैसे अलग है?

अनुरोध कई स्वतंत्र मशीनों में बाँटे जाते हैं। आप पूरी मशीन किराये पर नहीं लेते और न कोई वातावरण तैयार करते हैं, और भुगतान जितना इस्तेमाल करें उतना। जो दिया जाता है वह मॉडल इन्फ़रेंस है, कच्चा GPU किराया नहीं।

कौन-से सिस्टम और कार्ड गणना साझा कर सकते हैं?

NVIDIA (CUDA) या AMD और Intel (Vulkan) कार्ड वाले Windows और Linux (x86-64), और Apple सिलिकॉन वाले Mac (Metal)। उपयोग लायक ग्राफ़िक्स कार्ड के बिना कंप्यूटर अपना प्रोसेसर साझा कर सकता है। क्लाइंट तैयार किया जा रहा है।