独立したGPUのメッシュによる推論

チャット、コード、埋め込み、画像、動画に使えるOpenAI互換のAPIをひとつ。世界中の遊休GPUが参加してクレジットを獲得できます。

curl
curl https://babelmesh.ai/v1/chat/completions \
  -H "Authorization: Bearer $BABEL_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "messages": [{"role": "user",
                  "content": "Explain a hash ring"}]
  }'
ゲートウェイがモデルと、それに合うノードを選びます。
0
個の利用可能なモデル
none yet
現在できること

4種類の仕事を、1つのキーで

下の画像と動画は、このネットワーク自体で生成したものです。

チャットとコード

auto を指定すると、リクエストは読まれるだけで保存されません。短い質問は高速モデルへ、コードはコード用モデルへ、難しい問題は最も強力なモデルへ送られます。

python
client = OpenAI(base_url="https://babelmesh.ai/v1",
                api_key="sk-fab-...")
client.chat.completions.create(
    model="auto", stream=True,
    messages=[{"role": "user", "content": "..."}])
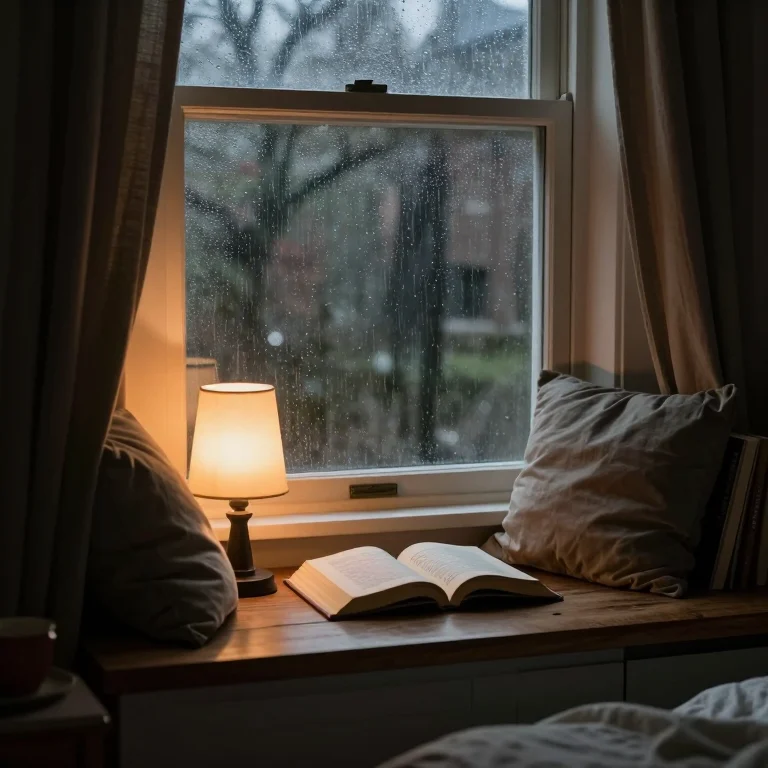
画像

一文から、一枚の絵を。

ネットワーク上で生成した画像:雨の夜、窓辺の卓上ランプと開いた本

埋め込み

検索や検索拡張のために、テキストをベクトルに変換します。普通のCPUで動く小さなモデルを使います。

curl
curl https://babelmesh.ai/v1/embeddings \
  -H "Authorization: Bearer $BABEL_KEY" \
  -d '{"model": "embedding-default",
       "input": ["a lighthouse at dawn"]}'

動画

短いクリップをバックグラウンドで生成します。数分かかり、完了すると保存できます。

リクエストに何が起こるか

  1. 送信

    あなたのアプリは、他のOpenAI互換サービスと同じように、キーを付けてAPIを呼び出します。

  2. 振り分け

    ゲートウェイは適したノードを選びます。モデル、プロンプトの長さ、現在の負荷を見て決めます。

  3. 計算

    ノードがモデルを実行し、回答をゲートウェイ経由でストリーミングで返します。

  4. 検証

    双方が受領書に署名し、結果の一部は確認のために再計算されます。

お持ちのものを貸しましょう

コンピューターがアイドルの間にクレジットを獲得できます。あなたが同意した後にのみ始まり、いつでも止められます。

  • グラフィックスカード

    NVIDIA、AMD、Intel、Apple シリコン。あなたが離席している間に、チャット、コード、画像、動画を処理します。

  • プロセッサーだけでも

    使えるGPUがない場合は、CPUを貸して小さなモデルと埋め込みを処理できます。使うのはスレッドの約半分だけです。

現在と今後

現在利用可能

  • チャット、コード、埋め込み、画像、動画
  • OpenAI互換のAPIなので、今お使いのツールがそのまま動きます
  • 稼働状況と速度をリアルタイムで見られるステータスページ

進行中(時期は未定)

  • GPUとCPUの共有に対応した Babel Mesh デスクトップクライアント
  • 獲得したクレジットの現金での支払い(本人確認と審査が必要)
  • より多く、より大きなモデル

よくある質問

料金はどうなっていますか?

利用料金はクレジットで計算します。テキストと埋め込みはトークン数、画像は1枚ごと、動画は1秒ごとです。計算資源を共有してクレジットを獲得することもできます。

送ったものは他の人に見られますか?

リクエストを処理するノードは内容を読めますが、あなたが誰かは分かりません。Babel Mesh は会話を保存せず、会計用の受領書にはハッシュと使用量しかありません。コンテンツルールに該当したリクエストだけが、該当箇所の前後の短い抜粋を残します。パスワード、ID番号、その他の機密情報は送らないでください。詳しくはセキュリティのページをご覧ください。

クラウドのGPUを借りるのと何が違いますか?

リクエストは、多数の独立したマシンに分散されます。マシンを丸ごと借りたり環境を整えたりする必要はなく、使った分だけ支払います。提供するのはモデルの推論であり、GPUそのものの貸し出しではありません。

どのシステムとカードで計算資源を共有できますか?

NVIDIA(CUDA)またはAMD・Intel(Vulkan)のカードを備えた Windows と Linux(x86-64)、および Apple シリコンの Mac(Metal)。使えるグラフィックスカードがないコンピューターは、プロセッサーを共有できます。クライアントは準備中です。