Inferência a partir de uma malha de GPUs independentes

Uma API compatível com a OpenAI para chat, código, embeddings, imagens e vídeo. GPUs ociosas de qualquer lugar podem entrar e ganhar créditos.

curl
curl https://babelmesh.ai/v1/chat/completions \
  -H "Authorization: Bearer $BABEL_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "messages": [{"role": "user",
                  "content": "Explain a hash ring"}]
  }'
O gateway escolhe o modelo e um nó adequado.
0
modelos disponíveis
none yet
o que ele pode fazer agora

Quatro tipos de trabalho, uma chave

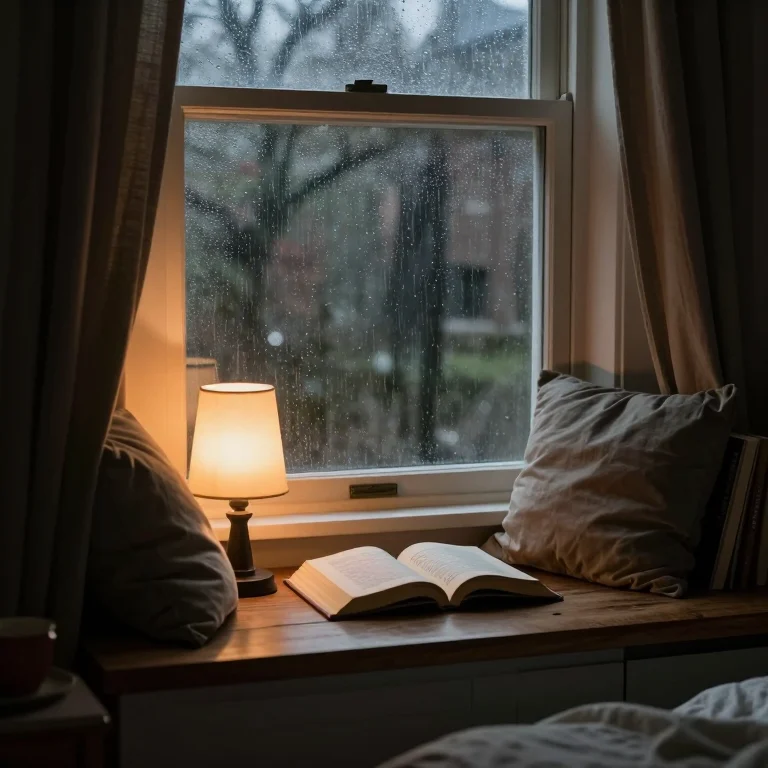
A imagem e o clipe abaixo foram gerados na própria rede.

Chat e código

Peça auto e a requisição é lida, não guardada: perguntas curtas vão para um modelo rápido, código para um modelo de código, problemas difíceis para o mais forte.

python
client = OpenAI(base_url="https://babelmesh.ai/v1",
                api_key="sk-fab-...")
client.chat.completions.create(
    model="auto", stream=True,
    messages=[{"role": "user", "content": "..."}])
Imagens

Uma frase, uma imagem.

Uma imagem gerada na rede: um abajur de mesa e um livro aberto junto a uma janela numa noite chuvosa

Embeddings

Texto para vetores para busca e recuperação, com um modelo pequeno que roda em CPUs comuns.

curl
curl https://babelmesh.ai/v1/embeddings \
  -H "Authorization: Bearer $BABEL_KEY" \
  -d '{"model": "embedding-default",
       "input": ["a lighthouse at dawn"]}'

Vídeo

Clipes curtos, gerados em segundo plano. Leva alguns minutos, e o arquivo está pronto para salvar quando termina.

O que acontece com uma requisição

  1. Enviar

    Seu aplicativo chama a API com uma chave, como em qualquer serviço compatível com a OpenAI.

  2. Direcionar

    O gateway escolhe um nó adequado: o modelo, o tamanho do prompt, a carga atual.

  3. Computação

    O nó executa o modelo e devolve a resposta em streaming pelo gateway.

  4. Verificar

    As duas partes assinam um recibo, e uma parte dos resultados é calculada de novo para conferi-los.

Empreste o que você tem

Ganhe créditos enquanto o computador está ocioso. Só começa depois que você concorda, e você pode parar a qualquer momento.

  • Uma placa de vídeo

    NVIDIA, AMD, Intel ou Apple silicon. Atende chat, código, imagens e vídeo enquanto você está fora.

  • Só um processador

    Sem GPU utilizável? Empreste a CPU para modelos pequenos e embeddings. Só cerca de metade das threads é usada.

Hoje e o que vem

Disponível agora

  • Chat, código, embeddings, imagens e vídeo
  • Uma API compatível com a OpenAI, então as ferramentas que você já usa funcionam
  • Uma página de status com disponibilidade e velocidade ao vivo

Em andamento, sem datas

  • O cliente de desktop do Babel Mesh, com compartilhamento de GPU e CPU
  • Pagamento em dinheiro dos créditos ganhos, com verificação de identidade e análise
  • Mais modelos, e maiores

Perguntas

Como é pago?

O uso é cobrado em créditos: por tokens em texto e embeddings, por imagem e por segundo de vídeo. Também é possível ganhar créditos compartilhando computação.

Outras pessoas podem ver o que eu envio?

O nó que atende sua requisição pode lê-la, mas não vê quem você é. O Babel Mesh não guarda conversas, e os recibos contábeis contêm só hashes e uso. Somente uma requisição que aciona uma regra de conteúdo deixa um pequeno trecho ao redor da ocorrência. Não envie senhas, números de documento ou outro material sensível. Mais na página de segurança.

Qual a diferença para alugar uma GPU na nuvem?

As requisições são distribuídas entre muitas máquinas independentes. Você não aluga uma máquina inteira nem monta um ambiente, e paga pelo que usa. O que se oferece é inferência de modelos, não aluguel de GPU bruta.

Quais sistemas e placas podem compartilhar computação?

Windows e Linux (x86-64) com placas NVIDIA (CUDA) ou AMD e Intel (Vulkan), e Macs com Apple silicon (Metal). Um computador sem placa de vídeo utilizável pode compartilhar o processador. O cliente está sendo preparado.

Faça a primeira chamada