Inferenza da una rete di GPU indipendenti

Un'unica API compatibile con OpenAI per chat, codice, embedding, immagini e video. Le GPU inattive ovunque possono unirsi e guadagnare crediti.

curl
curl https://babelmesh.ai/v1/chat/completions \
  -H "Authorization: Bearer $BABEL_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "messages": [{"role": "user",
                  "content": "Explain a hash ring"}]
  }'
Il gateway sceglie il modello e un nodo adatto.
0
modelli disponibili
none yet
cosa può fare ora

Quattro tipi di lavoro, una chiave

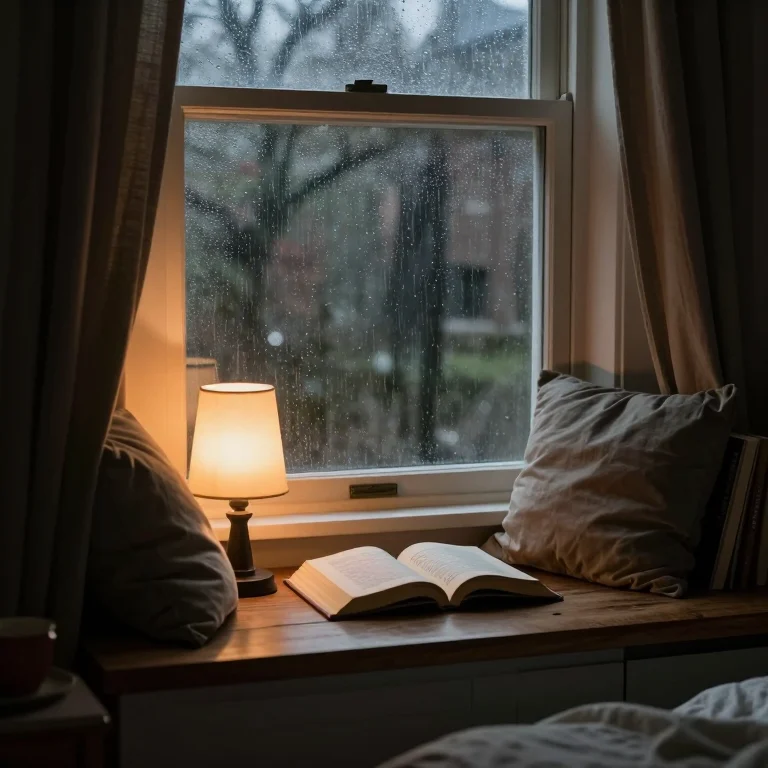
L'immagine e la clip qui sotto sono state generate sulla rete stessa.

Chat e codice

Chiedi auto e la richiesta viene letta, non conservata: le domande brevi vanno a un modello veloce, il codice a un modello per il codice, i problemi difficili al più potente.

python
client = OpenAI(base_url="https://babelmesh.ai/v1",
                api_key="sk-fab-...")
client.chat.completions.create(
    model="auto", stream=True,
    messages=[{"role": "user", "content": "..."}])
Immagini

Una frase, un'immagine.

Un'immagine generata sulla rete: una lampada da scrivania e un libro aperto accanto a una finestra in una notte di pioggia

Embedding

Da testo a vettori per ricerca e recupero, con un piccolo modello che gira su normali CPU.

curl
curl https://babelmesh.ai/v1/embeddings \
  -H "Authorization: Bearer $BABEL_KEY" \
  -d '{"model": "embedding-default",
       "input": ["a lighthouse at dawn"]}'

Video

Clip brevi, generate in background. Ci vogliono alcuni minuti e il file è pronto da salvare quando finisce.

Cosa succede a una richiesta

  1. Invia

    La tua app chiama l'API con una chiave, come con qualsiasi servizio compatibile con OpenAI.

  2. Instrada

    Il gateway sceglie un nodo adatto: il modello, la lunghezza del prompt, il carico attuale.

  3. Calcolo

    Il nodo esegue il modello e restituisce la risposta in streaming attraverso il gateway.

  4. Verifica

    Entrambe le parti firmano una ricevuta, e una parte dei risultati viene ricalcolata per verificarli.

Presta ciò che hai

Guadagna crediti mentre il computer è inattivo. Parte solo dopo il tuo consenso e puoi fermarti in qualsiasi momento.

  • Una scheda grafica

    NVIDIA, AMD, Intel o Apple silicon. Serve chat, codice, immagini e video mentre sei via.

  • Solo un processore

    Nessuna GPU utilizzabile? Presta la CPU per modelli piccoli ed embedding. Viene usata solo circa metà dei thread.

Oggi e dopo

Disponibile ora

  • Chat, codice, embedding, immagini e video
  • Un'API compatibile con OpenAI, così gli strumenti che usi già funzionano
  • Una pagina di stato con disponibilità e velocità in tempo reale

In corso, senza date

  • Il client desktop di Babel Mesh, con condivisione di GPU e CPU
  • Pagamento in contanti dei crediti guadagnati, con verifica dell'identità e revisione
  • Più modelli, e più grandi

Domande

Come si paga?

L'utilizzo è addebitato in crediti: a token per testo ed embedding, per immagine e per secondo di video. I crediti si possono guadagnare anche condividendo calcolo.

Altri possono vedere cosa invio?

Il nodo che serve la tua richiesta può leggerla, ma non può vedere chi sei. Babel Mesh non conserva le conversazioni, e le ricevute contabili contengono solo hash e utilizzo. Solo una richiesta che attiva una regola sui contenuti lascia un breve estratto attorno alla corrispondenza. Non inviare password, numeri di documento o altro materiale sensibile. Maggiori informazioni nella pagina sulla sicurezza.

In cosa è diverso dall'affittare una GPU cloud?

Le richieste sono distribuite su molte macchine indipendenti. Non affitti una macchina intera né prepari un ambiente, e paghi ciò che usi. Ciò che si offre è inferenza di modelli, non noleggio di GPU grezza.

Quali sistemi e schede possono condividere calcolo?

Windows e Linux (x86-64) con schede NVIDIA (CUDA) o AMD e Intel (Vulkan), e Mac con Apple silicon (Metal). Un computer senza una scheda grafica utilizzabile può condividere il processore. Il client è in preparazione.